En bref
OpenAI a annoncé une optimisation de la mise en cache des prompts pour son modèle GPT-6. Cette avancée vise à améliorer la rapidité et l’efficacité des réponses générées par l’IA, ce qui pourrait réduire les coûts opérationnels pour les entreprises. Les organisations françaises doivent surveiller l’impact de cette technologie sur leurs applications et leur stratégie d’adoption de l’IA.
- OpenAI a développé une nouvelle méthode pour optimiser la gestion des prompts dans GPT-6.
- Cette amélioration promet des réponses plus rapides et une meilleure efficacité des modèles IA.
- Les entreprises françaises pourraient bénéficier de coûts opérationnels réduits grâce à cette technologie.
- Une veille attentive est nécessaire pour évaluer les performances réelles et les implications de sécurité.
- Cette innovation s’inscrit dans la course à l’optimisation des grands modèles de langage (LLM).
Optimisation de la mise en cache des prompts pour GPT-6
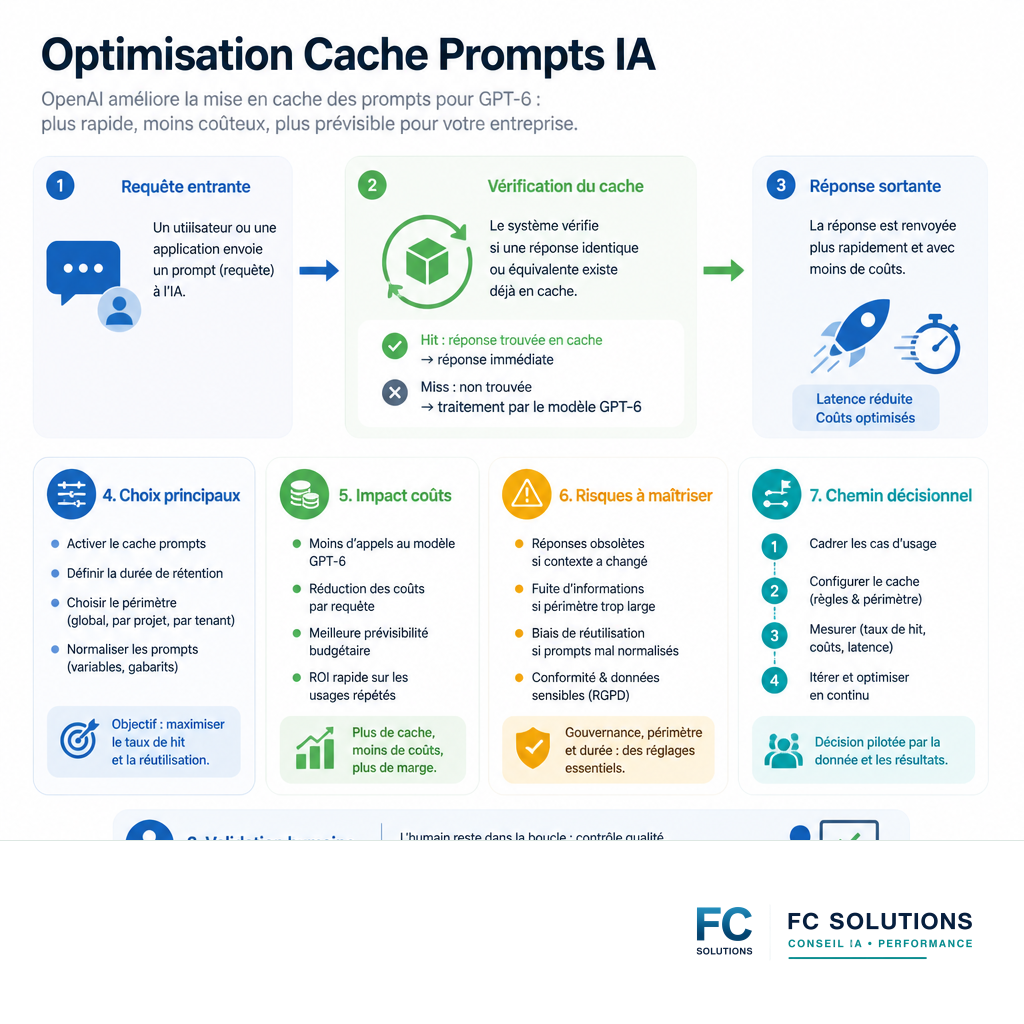
OpenAI, acteur majeur dans le développement de l’intelligence artificielle, a récemment dévoilé une avancée significative concernant son modèle GPT-6 : l’amélioration de la mise en cache des prompts. Cette technique, souvent méconnue du grand public mais cruciale pour l’efficacité des systèmes d’IA générative, vise à accélérer le traitement des requêtes et à réduire la charge computationnelle. Pour les entreprises françaises qui intègrent de plus en plus l’IA dans leurs processus métiers, cette optimisation représente une piste prometteuse pour améliorer la performance de leurs applications tout en maîtrisant les coûts associés.
La mise en cache des prompts consiste à stocker temporairement les requêtes les plus fréquentes ou les plus complexes afin de pouvoir les réutiliser rapidement sans avoir à les retraiter intégralement. Dans le contexte des grands modèles de langage (LLM) comme GPT-6, où chaque requête peut nécessiter une puissance de calcul considérable, cette approche permet de réduire la latence et d’augmenter le débit de traitement. OpenAI affirme que cette nouvelle méthode est particulièrement efficace pour les scénarios d’utilisation intensive, ce qui est pertinent pour de nombreuses applications d’entreprise, allant des chatbots de service client aux outils d’aide à la rédaction, en passant par l’analyse de données complexes.
Impact potentiel pour les entreprises françaises
L’annonce d’OpenAI concernant l’amélioration de la mise en cache des prompts pour GPT-6 soulève plusieurs questions pour les entreprises françaises. L’un des bénéfices les plus immédiats attendus est la réduction des coûts opérationnels. En traitant les requêtes plus rapidement et en optimisant l’utilisation des ressources de calcul, les entreprises pourraient voir une diminution de leurs dépenses liées à l’utilisation des API d’IA. Cela est particulièrement pertinent dans un contexte économique où la maîtrise des budgets est une priorité.
Au-delà des économies potentielles, cette optimisation peut également se traduire par une amélioration de l’expérience utilisateur. Des réponses plus rapides de la part des applications basées sur GPT-6 signifient une interaction plus fluide et plus satisfaisante pour les clients ou les employés. Pour les développeurs, cela peut ouvrir la voie à la création d’applications plus réactives et plus performantes, capables de gérer un volume de requêtes plus important sans dégradation notable des performances. L’objectif est de rendre l’IA plus accessible et plus intégrée dans les flux de travail quotidiens.
Points de vigilance et vérifications nécessaires
Bien que l’annonce d’OpenAI soit encourageante, il est essentiel pour les entreprises françaises d’adopter une approche prudente et de procéder à des vérifications approfondies avant d’intégrer pleinement cette nouvelle fonctionnalité. Le premier point de vigilance concerne les performances réelles en conditions d’utilisation variées. La documentation fournie par OpenAI suggère une amélioration notable, mais il est crucial de tester cette fonctionnalité dans des scénarios concrets représentatifs de l’usage prévu par l’entreprise. Des tests indépendants et des retours d’expérience d’autres utilisateurs seront précieux.
Un autre aspect critique à considérer est la sécurité et la confidentialité des données. Bien que la mise en cache des prompts vise à optimiser le traitement, il est impératif de s’assurer que les données sensibles ne sont pas stockées de manière inappropriée ou exposées. Il faut vérifier les politiques de confidentialité d’OpenAI relatives à cette nouvelle fonctionnalité et s’assurer qu’elles sont conformes aux réglementations en vigueur, notamment le Règlement général sur la protection des données (RGPD). La transparence sur la manière dont les données sont gérées est primordiale.
Enfin, il est important de comprendre les implications techniques de l’intégration. L’adoption de cette optimisation pourrait nécessiter des ajustements dans l’architecture des systèmes existants ou dans la manière dont les développeurs interagissent avec l’API de GPT-6. Les entreprises doivent évaluer la complexité de cette intégration et s’assurer que leurs équipes techniques disposent des compétences nécessaires pour la mettre en œuvre et la maintenir. La documentation technique fournie par OpenAI sera une ressource clé à cet égard.
Analyse FC Solutions : Vers une IA plus efficiente et coûte-effective
L’initiative d’OpenAI s’inscrit dans une tendance de fond visant à rendre les grands modèles de langage plus performants et plus accessibles. La mise en cache des prompts est une illustration concrète de la manière dont l’optimisation technique peut avoir un impact économique direct. Pour les entreprises françaises, cela signifie que l’adoption de l’IA pourrait devenir plus abordable, encourageant ainsi une diffusion plus large de ces technologies dans divers secteurs d’activité.
Cependant, il est crucial de ne pas se focaliser uniquement sur les gains de performance ou de coût. L’évaluation continue des risques liés à l’utilisation de l’IA reste une priorité. Les entreprises doivent s’assurer que l’implémentation de cette nouvelle fonctionnalité ne crée pas de vulnérabilités inattendues. Le cadre de gestion des risques liés à l’IA du NIST (National Institute of Standards and Technology) offre une méthodologie éprouvée pour identifier, évaluer et gérer ces risques de manière structurée.
Tableau : Cas d’usage de la mise en cache des prompts et validation humaine
Ce tableau présente des exemples d’application de la mise en cache des prompts et souligne l’importance de la validation humaine.
| Cas d’usage | Rôle de la mise en cache des prompts | Risque à vérifier | Validation humaine nécessaire |
|---|---|---|---|
| Service client automatisé (chatbot) | Accélère les réponses aux questions fréquentes, réduit la latence. | Réponses génériques ou inappropriées si le cache ne couvre pas la requête. | Vérification de la pertinence et de la personnalisation des réponses complexes ou sensibles. |
| Génération de contenu marketing | Permet de réutiliser des structures ou des phrases courantes pour des campagnes. | Manque d’originalité ou répétition si le cache est trop restrictif. | Relecture pour assurer la créativité, l’alignement avec la marque et l’absence d’erreurs factuelles. |
| Analyse de données et reporting | Accélère le traitement des requêtes d’analyse récurrentes. | Interprétation erronée des données si le contexte du cache est obsolète. | Validation des conclusions et des graphiques générés, vérification de la cohérence avec les données brutes. |
| Développement d’applications IA | Réduit le temps de réponse des API pour des fonctionnalités répétitives. | Erreurs de logique si le cache ne correspond pas à la requête actuelle de l’application. | Tests unitaires et d’intégration pour confirmer le bon fonctionnement de l’application avec le cache activé. |
Checklist : Points à vérifier avant l’adoption
- [✔] Performance mesurable : Vérifier que la mise en cache des prompts améliore significativement la latence et le débit pour vos cas d’usage spécifiques.
- [✔] Coût réel : Analyser l’impact sur la facture API ou les coûts d’infrastructure ; s’assurer que les économies sont réelles et durables.
- [✔] Sécurité des données : Confirmer que les données sensibles ne sont pas compromises par le mécanisme de cache.
- [✔] Conformité RGPD : S’assurer que le stockage et le traitement des données via le cache respectent les exigences du RGPD.
- [✔] Complexité d’intégration : Évaluer la facilité d’intégration avec vos systèmes existants et la disponibilité des compétences internes.
- [✔] Fiabilité des réponses : Tester la pertinence et l’exactitude des réponses générées avec le cache activé, notamment pour les requêtes complexes.
FAQ : Questions fréquentes
Q1 : Qu’est-ce que la mise en cache des prompts pour GPT-6 ?
Il s’agit d’une technique permettant de stocker les requêtes fréquemment utilisées par GPT-6 afin de les réutiliser rapidement, réduisant ainsi le temps de traitement et la charge computationnelle pour des réponses plus rapides et moins coûteuses.
Q2 : Quels sont les principaux avantages pour les entreprises françaises ?
Les avantages incluent une réduction potentielle des coûts opérationnels liés à l’utilisation des API d’IA, une amélioration de la vitesse de réponse des applications, et une meilleure expérience utilisateur globale.
Q3 : Cette optimisation pose-t-elle des risques de sécurité ?
Il est essentiel de vérifier que le mécanisme de cache ne compromet pas la confidentialité des données sensibles. OpenAI doit fournir des garanties claires à ce sujet, et les entreprises doivent s’assurer de leur conformité.
Q4 : Faut-il modifier l’architecture de nos systèmes pour utiliser cette fonctionnalité ?
L’intégration peut nécessiter des ajustements. Il est recommandé d’évaluer la complexité technique et de s’assurer que les équipes disposent des compétences nécessaires pour une mise en œuvre réussie.
Q5 : Comment évaluer l’efficacité réelle de cette mise en cache ?
Il est conseillé de réaliser des tests approfondis dans des conditions d’utilisation réelles, en mesurant la latence, le débit et la qualité des réponses avant une adoption à grande échelle.
A lire aussi
Continuer avec des sujets proches
Besoin d’appliquer ce sujet ?
Transformer l’analyse en workflow utile.
FC Solutions peut aider à cadrer le cas d’usage, choisir les outils, automatiser le test local et vérifier le coût réel avant production.
Services associés