En bref
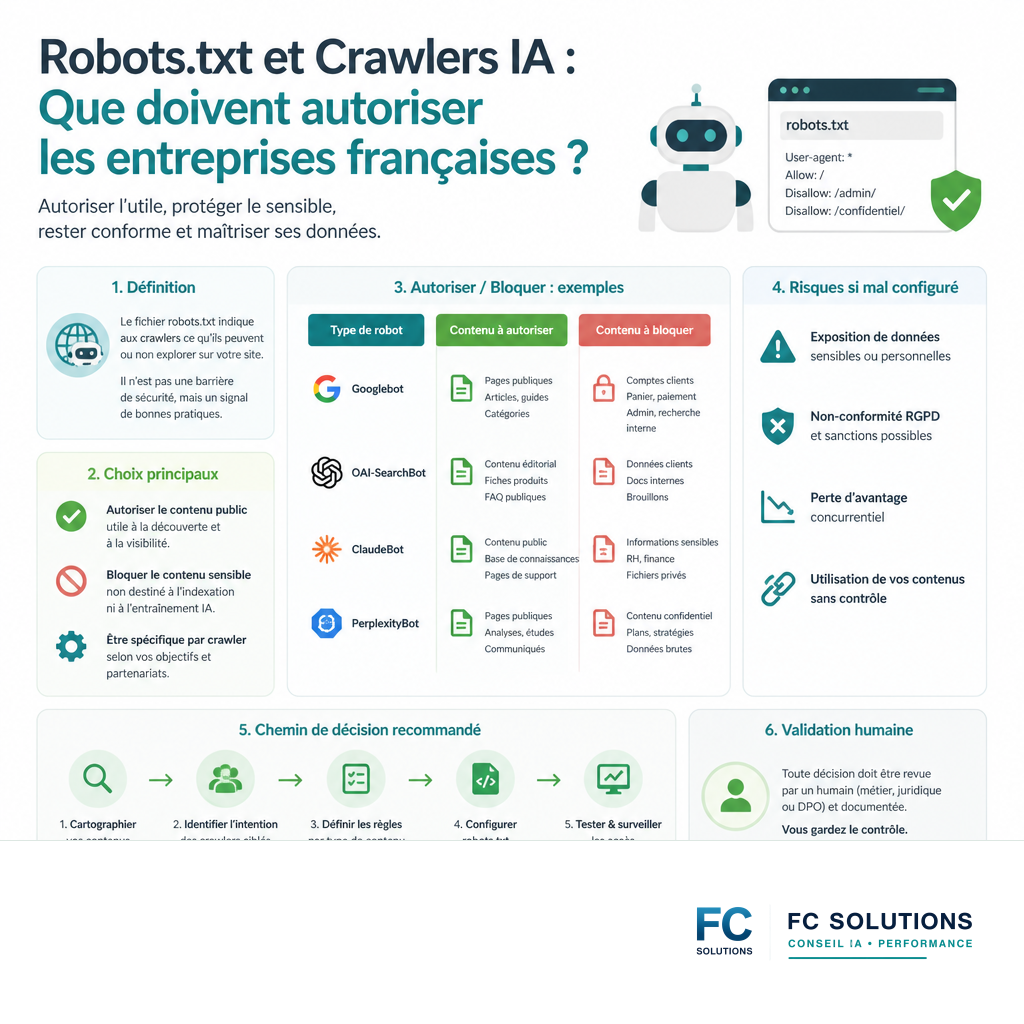
La gestion du fichier Robots.txt est essentielle pour les entreprises françaises afin de réguler l’accès des robots d’exploration IA à leurs contenus. Une configuration précise permet de sécuriser les données sensibles et d’orienter les IA vers les informations pertinentes. Il est impératif de définir clairement les autorisations pour maintenir une stratégie de contenu efficace et sécurisée.
- Le fichier Robots.txt permet aux propriétaires de sites web de spécifier quelles parties de leur site les robots d’exploration ne doivent pas visiter.
- L’émergence de crawlers IA dédiés, comme OAI-SearchBot, complexifie la gestion de ce fichier et nécessite une adaptation des règles.
- Une mauvaise configuration peut entraîner le blocage de contenus importants pour les IA ou l’exposition de données sensibles.
- Il est primordial de comprendre comment les IA interagissent avec les sites pour réguler leur accès via le Robots.txt.
- Une approche prudente et documentée est recommandée pour définir les autorisations et interdictions afin de protéger le contenu tout en bénéficiant des avancées de l’IA.
Pourquoi cette actualite merite-t-elle une analyse ?
Les moteurs de recherche comme Google et Bing intègrent de plus en plus l’intelligence artificielle dans leurs processus. Les crawlers IA, conçus pour collecter des données à grande échelle pour l’entraînement de modèles ou la fourniture de réponses directes, représentent une nouvelle catégorie d’agents d’exploration. Le fichier Robots.txt, outil établi pour guider les robots d’exploration traditionnels, doit désormais être adapté pour gérer ces nouveaux types d’agents. Il est donc primordial pour les entreprises de comprendre comment ces IA interagissent avec leurs sites et comment le Robots.txt peut être utilisé pour réguler cet accès, afin de protéger leur contenu tout en bénéficiant des avancées de l’IA.
Ce qui a changé : l’avènement des crawlers IA
Traditionnellement, le fichier robots.txt était utilisé pour indiquer aux robots des moteurs de recherche (comme Googlebot ou Bingbot) quelles pages ou sections d’un site web ils ne devaient pas indexer ou explorer. L’objectif était souvent de préserver la bande passante ou d’éviter l’indexation de contenu non pertinent. Cependant, l’émergence de modèles d’IA générative et de systèmes de recherche basés sur l’IA a introduit de nouveaux types de crawlers. Par exemple, OAI-SearchBot, le robot d’exploration d’OpenAI, est conçu pour collecter des informations afin d’améliorer les modèles de langage. Ces nouveaux crawlers peuvent avoir des objectifs différents de ceux des moteurs de recherche classiques, nécessitant une réévaluation des règles définies dans le fichier robots.txt. Il ne s’agit plus seulement de contrôler l’indexation, mais potentiellement de gérer l’accès aux données pour l’entraînement de modèles d’IA ou pour des recherches sémantiques avancées.
Impact commercial : Sécurité des données et optimisation de la stratégie IA
La manière dont une entreprise configure son fichier robots.txt a des implications directes sur sa stratégie de contenu et la sécurité de ses données. Autoriser aveuglément tous les crawlers IA pourrait exposer des informations sensibles, des données propriétaires ou du contenu en cours de développement. À l’inverse, un blocage trop restrictif pourrait empêcher des IA légitimes d’accéder à des données publiques nécessaires pour des analyses ou pour améliorer la pertinence des réponses générées. Pour les entreprises françaises, cela signifie qu’une gestion proactive et réfléchie du robots.txt est indispensable. Elle permet de :
- Protéger la propriété intellectuelle et les données confidentielles.
- Contrôler les coûts d’exploration en évitant que les IA ne surchargent les serveurs inutilement.
- Orienter l’IA vers les contenus les plus pertinents pour améliorer la qualité des résultats ou des modèles entraînés.
- Se conformer aux réglementations sur la protection des données, comme le Règlement général sur la protection des données (RGPD), en limitant l’accès aux informations personnelles.
Une stratégie mal définie peut entraîner des risques de sécurité, une perte de contrôle sur la manière dont les données sont utilisées, et potentiellement nuire à la réputation de l’entreprise.
Exemple concret : Gérer l’accès pour un site e-commerce
Considérons une entreprise française de vente en ligne qui souhaite utiliser l’IA pour analyser les tendances du marché et améliorer ses recommandations produits. Elle dispose d’un catalogue produits détaillé, de fiches techniques, mais aussi de sections réservées aux clients (historique de commandes, informations personnelles) et de pages de développement (brouillons d’articles de blog, pages de test).
| Robot (User-agent) | Rôle | Exemple de tâche | Risque potentiel | Validation humaine |
|---|---|---|---|---|
| Googlebot | Crawler de référencement général | Indexer les pages produits publiques pour le moteur de recherche. | Indexation de contenu non pertinent ou obsolète. | [✔] Vérifier que seules les pages publiques sont indexées. |
| OAI-SearchBot | Crawler IA d’OpenAI | Collecter des informations sur les descriptions de produits et les avis clients pour améliorer les modèles de langage. | Accès aux données clients ou aux informations sensibles si mal configuré. | [✔] Bloquer l’accès aux sections clients et aux pages de développement. |
| Bingbot | Crawler de référencement Bing | Indexer le contenu public du site. | Similaire à Googlebot. | [✔] Assurer la cohérence avec Googlebot. |
| * (tous les autres robots) | Robots non spécifiés | Par défaut, autoriser l’accès aux contenus publics. | Accès non désiré à des zones sensibles. | [✔] Spécifier explicitement les blocages pour les zones sensibles. |
Dans cet exemple, l’entreprise autoriserait les robots classiques à indexer son contenu public. Pour OAI-SearchBot, elle autoriserait l’accès aux descriptions de produits et aux avis clients, mais bloquerait explicitement l’accès aux sections clients et aux pages de développement. Cette approche permet de tirer parti de l’IA tout en maintenant un contrôle strict sur les données.
Analyse FC Solutions : Une approche stratégique indispensable
L’utilisation du fichier robots.txt pour gérer les crawlers IA n’est pas une simple tâche technique, mais une composante stratégique de la gestion de contenu et de la sécurité des données. Les entreprises françaises doivent adopter une vision proactive :
- Identifier les crawlers IA pertinents : Comprendre quels types d’IA accèdent à votre site et dans quel but est la première étape. Cela inclut les robots des moteurs de recherche, mais aussi ceux des plateformes d’IA spécialisées.
- Définir des règles granulaires : Le fichier robots.txt permet des règles spécifiques par robot (user-agent) et par chemin d’accès (path). Il est crucial de l’utiliser pour différencier les accès autorisés et refusés.
- Sécuriser les données sensibles : Les sections contenant des informations personnelles, des données financières, des documents internes ou du contenu en développement doivent être systématiquement bloquées pour tous les crawlers, sauf si une autorisation explicite et contrôlée est mise en place.
- Optimiser l’exploration pour l’IA : Pour les contenus publics destinés à être utilisés par des IA (par exemple, des descriptions de produits pour un chatbot), il est bénéfique de s’assurer qu’ils sont accessibles et bien structurés.
- Mettre en place une veille technologique : Les capacités et les objectifs des crawlers IA évoluent rapidement. Il est nécessaire de surveiller les annonces des principaux acteurs (OpenAI, Google, Microsoft) et d’ajuster la configuration du robots.txt en conséquence.
Une gestion rigoureuse du robots.txt est donc un levier essentiel pour les entreprises souhaitant naviguer sereinement dans l’écosystème de l’IA, en équilibrant l’ouverture nécessaire à l’innovation et la protection indispensable de leurs actifs numériques.
Limitations et points à vérifier
Le fichier robots.txt est un protocole de politesse, pas une mesure de sécurité infaillible. Il repose sur la bonne volonté des robots d’exploration à respecter les directives. Les robots malveillants ou non conformes peuvent ignorer ces règles. De plus, la complexité croissante des sites web et la diversité des crawlers IA rendent la configuration du robots.txt un exercice potentiellement délicat. Il est donc crucial de vérifier régulièrement la bonne application des règles et de considérer des mesures de sécurité supplémentaires pour les données les plus sensibles.
Checklist de vérification
- [✔] Identifier tous les robots d’exploration pertinents : Lister les user-agents des principaux moteurs de recherche et des plateformes IA susceptibles d’accéder à votre site.
- [✔] Analyser la sensibilité des contenus : Cartographier les différentes sections de votre site et évaluer le niveau de sensibilité des données qu’elles contiennent.
- [✔] Définir des règles spécifiques par robot : Créer des directives claires pour chaque user-agent, autorisant ou bloquant l’accès à des chemins d’accès spécifiques.
- [✔] Bloquer systématiquement les zones sensibles : S’assurer que les répertoires contenant des données personnelles, des informations confidentielles ou du contenu non publié sont inaccessibles aux crawlers.
- [✔] Tester la configuration du Robots.txt : Utiliser les outils de test disponibles (par exemple, Google Search Console) pour vérifier que les règles sont interprétées correctement.
- [✔] Documenter la politique d’accès : Conserver une trace écrite des décisions prises concernant les autorisations et les blocages, ainsi que les raisons sous-jacentes.
- [✔] Planifier des revues périodiques : Mettre en place un calendrier pour réviser et mettre à jour le fichier robots.txt, notamment en cas de modification de l’architecture du site ou de l’émergence de nouveaux crawlers IA.
FAQ : Questions fréquentes
Q1 : Qu’est-ce que le fichier Robots.txt ?
Le fichier Robots.txt est un protocole standardisé qui permet aux administrateurs de sites web d’indiquer aux robots d’exploration (comme ceux de Google ou d’OpenAI) quelles parties de leur site ils ne doivent pas explorer ou indexer. C’est une directive de politesse pour les robots.
Q2 : Pourquoi les crawlers IA comme OAI-SearchBot sont-ils différents des robots traditionnels ?
Les crawlers IA comme OAI-SearchBot sont conçus pour collecter des données à grande échelle afin d’entraîner des modèles d’intelligence artificielle ou de fournir des réponses directes. Leurs objectifs peuvent différer de ceux des robots de moteurs de recherche classiques, qui visent principalement l’indexation pour le référencement.
Q3 : Quels sont les risques si je ne configure pas correctement mon Robots.txt pour les crawlers IA ?
Vous risquez d’exposer des données sensibles ou confidentielles si vous autorisez l’accès sans discernement, ou de bloquer l’accès à des contenus publics importants pour l’entraînement ou la recherche des IA si vous êtes trop restrictif.
Q4 : Le Robots.txt est-il une mesure de sécurité suffisante pour protéger mes données ?
Non, le Robots.txt est un protocole de politesse. Il repose sur la coopération des robots. Les robots malveillants peuvent l’ignorer. Pour une sécurité renforcée, des mesures comme l’authentification, le chiffrement ou le blocage IP sont nécessaires pour les données critiques.
Q5 : Comment puis-je savoir quels crawlers IA accèdent à mon site ?
Vous pouvez consulter les journaux de votre serveur web pour identifier les user-agents des robots qui visitent votre site. Des outils comme Google Search Console fournissent également des informations sur l’exploration de votre site par Googlebot.
Q6 : Dois-je bloquer tous les crawlers IA par défaut ?
Il n’est pas recommandé de tout bloquer par défaut. Une approche nuancée est préférable : autorisez l’accès aux contenus publics pertinents pour l’IA, tout en bloquant spécifiquement les zones contenant des données sensibles ou non destinées à être publiques.
Note sur les sources
Cet article s’appuie sur les directives de Google concernant le fichier robots.txt et les bonnes pratiques d’exploration, ainsi que sur les informations relatives aux robots d’exploration d’IA comme OAI-SearchBot. Les sources fournies par Google expliquent le fonctionnement du robots.txt et son rôle dans l’optimisation pour les moteurs de recherche et l’IA. Les informations sur OAI-SearchBot proviennent de la documentation d’OpenAI.
A lire aussi
Continuer avec des sujets proches
Besoin d’appliquer ce sujet ?
Transformer l’analyse en workflow utile.
FC Solutions peut aider à cadrer le cas d’usage, choisir les outils, automatiser le test local et vérifier le coût réel avant production.
Services associés