
En bref
OpenAI a développé un nouveau mécanisme permettant aux sites web d’exprimer clairement leurs préférences quant à l’utilisation de leurs contenus pour l’entraînement de ses modèles d’intelligence artificielle. Cette fonctionnalité vise à offrir plus de contrôle aux propriétaires de sites et à fournir des signaux clairs aux développeurs d’IA. Les entreprises françaises doivent comprendre les implications de cette démarche pour leur stratégie de contenu et leur conformité potentielle.
- Les sites web peuvent désormais indiquer si leurs contenus peuvent être utilisés pour l’entraînement des modèles d’OpenAI.
- Ce mécanisme vise à améliorer la transparence et le respect des volontés des créateurs de contenu.
- Les développeurs d’IA recevront des indications plus précises sur les données autorisées pour l’entraînement.
- Cette initiative s’inscrit dans un contexte de régulation croissante de l’intelligence artificielle.
- Les entreprises françaises doivent évaluer comment cette évolution affecte leur présence en ligne et leurs données.
Un nouveau standard pour l’entraînement des IA
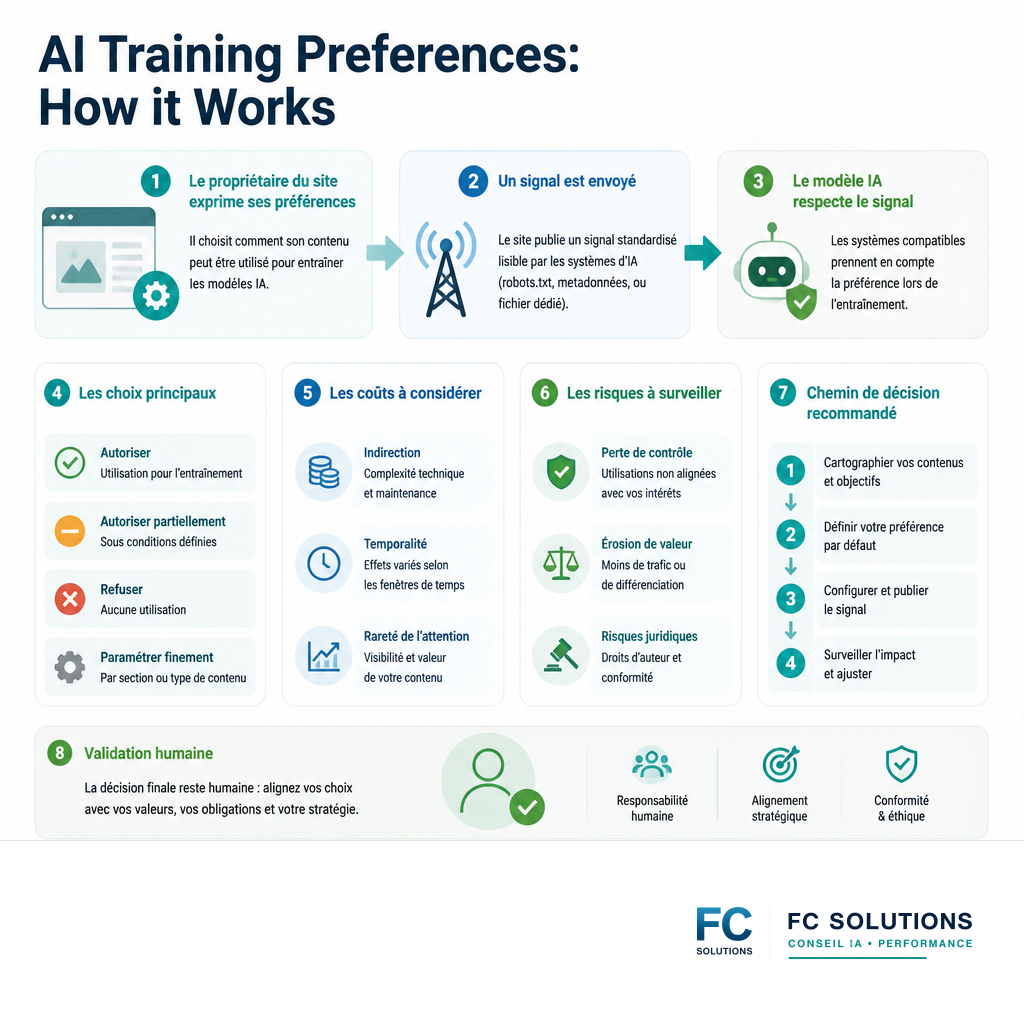
OpenAI annonce une avancée significative dans la manière dont les modèles d’intelligence artificielle sont entraînés. La société a mis en place un système permettant aux propriétaires de sites web d’exprimer leurs préférences concernant l’utilisation de leurs contenus pour l’entraînement de ses modèles d’IA. Cette fonctionnalité, détaillée dans une publication récente, vise à établir une nouvelle norme pour la collecte et l’utilisation des données dans le développement de l’IA.
Jusqu’à présent, la capacité des sites web à contrôler si leurs données étaient utilisées pour entraîner des modèles d’IA était limitée et souvent implicite. Avec ce nouveau mécanisme, OpenAI cherche à rendre ce processus plus explicite et plus accessible. Les propriétaires de sites pourront signaler si leur contenu peut être utilisé pour l’entraînement, ou s’ils préfèrent que ces données soient exclues. Ces préférences seront communiquées aux futurs modèles d’OpenAI.
Cette initiative est particulièrement pertinente dans le contexte actuel où la régulation de l’intelligence artificielle prend de l’ampleur. L’Union Européenne, par exemple, avec son AI Act, impose des cadres stricts pour le développement et le déploiement des systèmes d’IA, notamment en ce qui concerne la transparence et la gestion des données. En facilitant l’expression des préférences, OpenAI anticipe potentiellement certaines exigences réglementaires et renforce la confiance dans son écosystème.
Implications pour les entreprises françaises
Pour les entreprises françaises, cette évolution soulève plusieurs points d’attention cruciaux. La manière dont les données sont collectées et utilisées pour l’entraînement des IA a des implications directes sur la propriété intellectuelle, la confidentialité et la conformité réglementaire. Les entreprises qui publient du contenu en ligne, qu’il s’agisse de textes, d’images ou d’autres formes de données, doivent désormais considérer comment elles souhaitent que ce contenu soit utilisé par des acteurs comme OpenAI.
Il est essentiel pour les entreprises d’évaluer leur stratégie de contenu à la lumière de cette nouvelle fonctionnalité. Souhaitent-elles autoriser l’utilisation de leurs données pour l’entraînement ? Si oui, sous quelles conditions ? Si non, comment s’assurer que leurs préférences sont respectées ? La capacité d’OpenAI à interpréter et à respecter ces signaux sera déterminante.
De plus, cette démarche s’inscrit dans une tendance plus large de responsabilisation des développeurs d’IA. Les entreprises qui utilisent des outils basés sur l’IA, ou qui développent leurs propres solutions, doivent également se préoccuper de la provenance et de la légalité des données d’entraînement. Le respect des préférences exprimées par les sites web pourrait devenir un élément clé de la conformité éthique et légale dans le domaine de l’IA.
Un cadre de confiance et de contrôle
Le mécanisme proposé par OpenAI vise à construire un cadre de confiance entre les créateurs de contenu et les développeurs d’IA. En permettant aux sites web de définir leurs propres règles, OpenAI espère encourager une utilisation plus responsable et éthique de l’intelligence artificielle. Cela pourrait également aider à prévenir les utilisations non désirées de contenus protégés par le droit d’auteur ou soumis à des licences spécifiques.
Les développeurs d’IA, quant à eux, bénéficieront de signaux plus clairs, ce qui pourrait potentiellement améliorer la qualité et la pertinence des modèles entraînés. Une meilleure compréhension des données autorisées peut conduire à des modèles plus performants et mieux alignés avec les attentes sociétales et réglementaires. Le NIST AI Risk Management Framework, par exemple, souligne l’importance de la gouvernance des données et de la gestion des risques tout au long du cycle de vie d’un système d’IA, et cette initiative d’OpenAI s’aligne sur ces principes.
Il est important de noter que l’efficacité de ce système dépendra de sa mise en œuvre technique et de son adoption par la communauté des développeurs d’IA. La capacité d’OpenAI à communiquer clairement ces préférences à ses modèles et à s’assurer qu’elles sont respectées sera un facteur déterminant.
Exemple concret : une PME française et ses données
Imaginons une PME française spécialisée dans la création de contenu éducatif pour le secteur de la santé. Cette entreprise publie régulièrement des articles de blog, des études de cas et des infographies sur son site web. Jusqu’à présent, elle n’avait pas de moyen direct d’indiquer si elle souhaitait que ces contenus soient utilisés pour entraîner des modèles d’IA comme ceux d’OpenAI.
Avec le nouveau mécanisme, cette PME peut désormais configurer son site web pour signaler qu’elle n’autorise pas l’utilisation de ses contenus pour l’entraînement des IA. Cela pourrait être fait via une balise spécifique dans le code du site ou une configuration dans son fichier robots.txt, selon les directives d’OpenAI. Cette décision est motivée par le désir de protéger son contenu, potentiellement sujet à des droits d’auteur, et de s’assurer que les informations médicales qu’elle diffuse ne soient pas mal interprétées ou réutilisées sans consentement dans des applications d’IA génératives.
Cette action permet à la PME de mieux contrôler l’exploitation de ses actifs numériques et de se conformer à une approche prudente en matière de gestion des données, en anticipation des futures réglementations et des meilleures pratiques éthiques.
Analyse FC Solutions
L’initiative d’OpenAI marque une étape importante vers une IA plus responsable et transparente. En donnant aux créateurs de contenu un moyen explicite d’exprimer leurs préférences, la société répond à une préoccupation croissante concernant l’utilisation des données pour l’entraînement des modèles. Pour les entreprises françaises, cela représente une opportunité de mieux maîtriser leur présence numérique et de s’aligner sur les exigences réglementaires émergentes, notamment celles liées à la protection des données et à la propriété intellectuelle.
Cependant, il est crucial de rester prudent. L’efficacité réelle de ce mécanisme dépendra de son adoption par l’ensemble de l’écosystème de l’IA et de la capacité des modèles à interpréter et à respecter ces préférences de manière fiable. Les entreprises doivent rester vigilantes quant aux communications futures d’OpenAI et des autres acteurs de l’IA concernant l’évolution de ces pratiques.
Checklist de vérification pour les entreprises
- [✔] Comprendre le mécanisme : Examiner attentivement les directives d’OpenAI sur la manière d’exprimer les préférences d’entraînement IA.
- [✔] Évaluer la stratégie de contenu : Déterminer si l’entreprise souhaite autoriser ou interdire l’utilisation de ses contenus pour l’entraînement des IA.
- [✔] Implémenter techniquement : Mettre en œuvre les configurations nécessaires sur le site web (ex: robots.txt, balises spécifiques) selon les recommandations d’OpenAI.
- [✔] Surveiller les évolutions : Rester informé des mises à jour d’OpenAI et des pratiques des autres développeurs d’IA concernant l’entraînement des données.
- [✔] Consulter les experts : En cas de doute, consulter un juriste spécialisé en droit du numérique ou un expert en conformité IA.
FAQ : Questions fréquentes
Q1 : Qu’est-ce que le nouveau mécanisme d’OpenAI ?
Il s’agit d’un système permettant aux propriétaires de sites web d’indiquer s’ils autorisent ou non l’utilisation de leurs contenus pour entraîner les modèles d’intelligence artificielle d’OpenAI. Cela vise à accroître la transparence et le contrôle sur l’utilisation des données.
Q2 : Pourquoi est-ce important pour les entreprises françaises ?
Cela affecte la manière dont leurs contenus en ligne peuvent être utilisés, impactant potentiellement la propriété intellectuelle, la confidentialité des données et la conformité avec des réglementations comme le RGPD ou l’AI Act européen.
Q3 : Comment un site web peut-il exprimer ses préférences ?
OpenAI fournira des instructions techniques, probablement via des modifications dans le code du site web ou des configurations spécifiques comme le fichier robots.txt, pour signaler les préférences d’entraînement.
Q4 : Est-ce que cela garantit que mes données ne seront pas utilisées ?
Ce mécanisme fournit un signal clair aux modèles d’OpenAI. L’efficacité dépendra de la capacité d’OpenAI à intégrer et respecter ces préférences dans ses futurs entraînements.
Q5 : Quels sont les risques si une entreprise n’exprime pas ses préférences ?
Si aucune préférence n’est exprimée, le contenu pourrait être considéré comme disponible pour l’entraînement par défaut, selon les futures politiques d’OpenAI. Cela pourrait entraîner une utilisation non désirée des données.
Q6 : Cette initiative est-elle obligatoire ?
Non, l’expression des préférences est volontaire. Cependant, elle est fortement recommandée pour les entreprises souhaitant maîtriser l’usage de leurs contenus en ligne dans le contexte de l’IA.
A lire aussi
Continuer avec des sujets proches
Besoin d’appliquer ce sujet ?
Transformer l’analyse en workflow utile.
FC Solutions peut aider à cadrer le cas d’usage, choisir les outils, automatiser le test local et vérifier le coût réel avant production.
Services associés