En bref
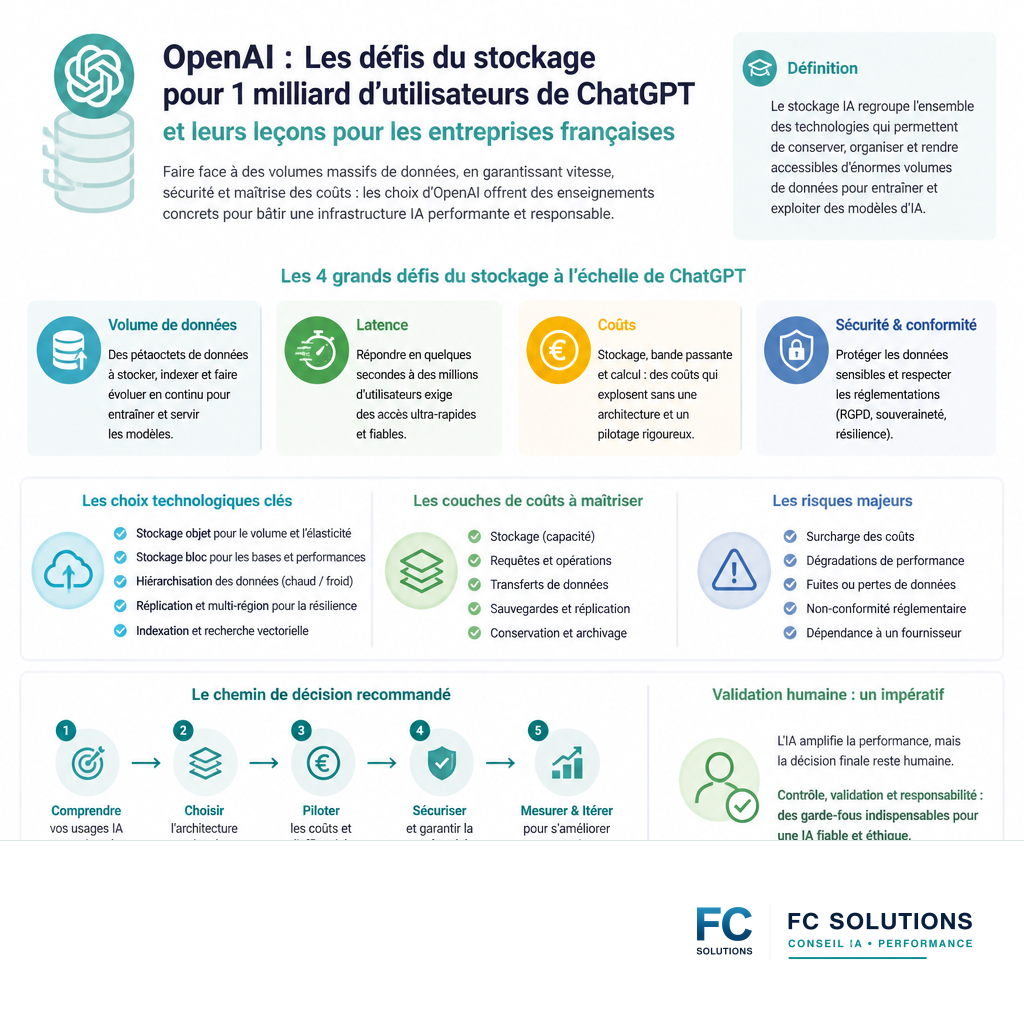
OpenAI a partagé les défis techniques rencontrés pour adapter son infrastructure de stockage afin de supporter plus d’un milliard d’utilisateurs de ChatGPT. Ces enseignements sont particulièrement pertinents pour les entreprises françaises qui déploient des solutions d’IA à grande échelle. Comprendre ces enjeux permet d’anticiper les besoins en capacité, en performance et en sécurité des données.
- La gestion d’un volume de données massif pour des millions d’utilisateurs simultanés requiert une architecture de stockage hautement évolutive et résiliente.
- L’optimisation des coûts de stockage et de traitement est un facteur clé pour la viabilité économique des services d’IA à grande échelle.
- La sécurité et la confidentialité des données utilisateurs doivent être une priorité absolue, même lors d’une croissance rapide.
- La latence dans l’accès aux données est critique pour garantir une expérience utilisateur fluide et réactive avec des modèles comme ChatGPT.
- Les leçons apprises par OpenAI peuvent guider les entreprises françaises dans la planification et l’exécution de leurs propres stratégies d’infrastructure IA.
Les défis de la mise à l’échelle du stockage chez OpenAI
OpenAI a récemment publié une analyse détaillée des défis techniques qu’elle a dû relever pour adapter son infrastructure de stockage afin de servir plus d’un milliard d’utilisateurs de ChatGPT. Cet article, qui constitue la première partie d’une série, met en lumière la complexité de la gestion de données à une échelle sans précédent. L’entreprise souligne que la croissance exponentielle de l’utilisation de ses modèles a nécessité des innovations significatives en matière d’architecture de stockage, de performance et de gestion des coûts. La capacité à stocker, accéder et traiter des pétaoctets de données de manière efficace et sécurisée est fondamentale pour le fonctionnement de services d’IA générative à l’échelle mondiale. Les équipes d’OpenAI ont dû concevoir des solutions capables de gérer des requêtes simultanées massives tout en maintenant une faible latence. Cela implique non seulement des choix matériels et logiciels, mais aussi une optimisation continue des processus et des algorithmes.
Implications pour les entreprises françaises
Pour les entreprises françaises, qu’elles soient des startups innovantes, des PME en phase de transformation numérique ou de grandes structures établies, les enseignements tirés par OpenAI sont d’une valeur considérable. Le déploiement de solutions d’intelligence artificielle, qu’il s’agisse de chatbots internes, d’outils d’analyse de données ou de systèmes de recommandation, implique inévitablement une gestion accrue des données. La planification d’une infrastructure de stockage robuste et évolutive est donc une étape cruciale avant même le développement ou l’adoption de modèles d’IA. Ignorer ces aspects peut entraîner des goulets d’étranglement, une dégradation des performances, une augmentation imprévue des coûts et, dans le pire des cas, des failles de sécurité compromettant les données sensibles des clients ou de l’entreprise.
Performance et latence : des facteurs critiques
L’un des aspects les plus critiques soulignés par OpenAI est la nécessité de minimiser la latence. Pour des applications interactives comme ChatGPT, chaque milliseconde compte pour offrir une expérience utilisateur fluide. Cela signifie que le stockage doit être non seulement volumineux, mais aussi extrêmement rapide d’accès. Les solutions de stockage traditionnelles peuvent s’avérer insuffisantes face à ces exigences. Les entreprises françaises qui envisagent d’intégrer des IA conversationnelles ou des systèmes nécessitant des réponses en temps réel doivent impérativement considérer des technologies de stockage optimisées pour la performance. Cela peut inclure des solutions de stockage en mémoire (in-memory storage), des systèmes de mise en cache avancés, ou des architectures de bases de données distribuées conçues pour des accès à faible latence.
Sécurité et confidentialité des données
Dans un contexte réglementaire de plus en plus strict, notamment avec le Règlement général sur la protection des données (RGPD), la sécurité et la confidentialité des données sont primordiales. OpenAI insiste sur l’importance de ces aspects, même dans un environnement de croissance rapide. La gestion des accès, le chiffrement des données au repos et en transit, ainsi que la mise en place de mécanismes de détection et de réponse aux incidents sont essentiels. Les entreprises françaises doivent intégrer la sécurité dès la conception de leur infrastructure IA (security by design). Cela implique une cartographie précise des données traitées, une classification de leur sensibilité, et la mise en œuvre de contrôles d’accès stricts. Le choix des fournisseurs de solutions de stockage et de cloud doit également se faire en tenant compte de leurs certifications et de leurs engagements en matière de sécurité et de conformité.
Optimisation des coûts
La mise à l’échelle d’une infrastructure de stockage pour des services d’IA peut engendrer des coûts considérables. OpenAI mentionne l’importance de l’optimisation des coûts, suggérant que des solutions efficaces ne sont pas nécessairement les plus coûteuses. Cela peut passer par le choix de technologies de stockage adaptées au volume et à la fréquence d’accès aux données, l’utilisation de niveaux de stockage différenciés (stockage chaud, froid), ou encore la mise en place de politiques de rétention et d’archivage efficaces. Pour les PME françaises, une gestion rigoureuse des coûts d’infrastructure est un facteur de succès déterminant. Il est conseillé de réaliser des simulations de coûts basées sur des scénarios d’utilisation réalistes et d’évaluer le retour sur investissement potentiel de chaque solution envisagée. L’approche FinOps, qui vise à optimiser les dépenses cloud, peut s’avérer particulièrement utile.
Exemple concret : une PME française et son chatbot interne
Imaginons une PME française spécialisée dans le conseil, qui souhaite déployer un chatbot interne basé sur un modèle de langage pour aider ses consultants à retrouver rapidement des informations dans une vaste base de connaissances interne (documents de projets, rapports, études de cas). Le volume de ces documents peut atteindre plusieurs téraoctets.
| Agent ou étape | Rôle | Exemple de tâche | Risque | Validation humaine |
|---|---|---|---|---|
| Ingestion des documents | Collecteur de données | Scanner et indexer tous les documents internes (PDF, DOCX, TXT). | Perte de données, indexation incomplète, mauvaise classification. | Vérification de l’exhaustivité et de la pertinence des documents indexés. |
| Traitement et vectorisation | Modèle d’embedding | Convertir le contenu des documents en vecteurs numériques pour la recherche sémantique. | Biais dans la vectorisation, perte d’informations contextuelles. | Tests de similarité sémantique sur des requêtes clés. |
| Stockage des vecteurs | Base de données vectorielle | Stocker les vecteurs et leurs métadonnées associées pour une recherche rapide. | Corruption des données, latence d’accès, coûts de stockage excessifs. | Surveillance de la performance et de l’intégrité des données. |
| Requête utilisateur | Interface chatbot | Recevoir la question de l’utilisateur et la transformer en requête pour la base de données vectorielle. | Mauvaise interprétation de la requête, absence de contexte. | Vérification de la pertinence de la requête avant l’envoi. |
| Récupération et génération de réponse | Modèle de langage | Interroger la base de données vectorielle, récupérer les informations pertinentes et générer une réponse cohérente. | Réponse incorrecte, hallucination du modèle, informations obsolètes. | Relecture et validation de la réponse générée pour exactitude et pertinence. |
FC Solutions analyse : Anticiper la croissance pour une IA durable
La publication d’OpenAI sur ses défis de stockage est une piqûre de rappel essentielle pour toute organisation envisageant de déployer des solutions d’IA à grande échelle. La capacité à gérer des volumes de données massifs, à garantir une performance constante et à maintenir une sécurité sans faille n’est pas une option, mais une nécessité opérationnelle. Les entreprises françaises doivent intégrer ces considérations dès les premières phases de planification de leurs projets IA. Une stratégie d’infrastructure bien pensée, qui anticipe la croissance et intègre les principes de sécurité et d’optimisation des coûts, est le fondement d’une adoption réussie et durable de l’intelligence artificielle.
Limitations et points à vérifier
L’article d’OpenAI, bien que détaillé, se concentre sur les aspects techniques de leur infrastructure. Il serait utile de vérifier les détails spécifiques concernant les technologies de stockage utilisées (type de bases de données, solutions cloud spécifiques, stratégies de mise en cache). De plus, les coûts réels associés à cette mise à l’échelle, au-delà des principes généraux d’optimisation, mériteraient d’être précisés. Pour les entreprises françaises, il est crucial de vérifier comment ces principes s’appliquent à leurs propres contraintes budgétaires et réglementaires, notamment en matière de souveraineté des données.
Checklist de vérification pour l’infrastructure IA
- [✔] Évaluation des besoins : Définir clairement les volumes de données attendus, les types d’accès et les exigences de performance pour anticiper la capacité de stockage nécessaire.
- [✔] Choix technologiques : Sélectionner des solutions de stockage et des architectures de bases de données adaptées aux charges de travail IA, en privilégiant la scalabilité et la faible latence.
- [✔] Sécurité par conception : Intégrer des mesures de sécurité robustes (chiffrement, gestion des accès, audit) dès le début du projet d’infrastructure IA.
- [✔] Optimisation des coûts : Mettre en place une stratégie FinOps pour surveiller et optimiser les dépenses liées au stockage et au traitement des données IA.
- [✔] Conformité réglementaire : S’assurer que l’infrastructure respecte les réglementations en vigueur, telles que le RGPD, en matière de protection des données.
- [✔] Tests de performance : Effectuer des tests rigoureux pour valider la latence, le débit et la résilience de l’infrastructure sous différentes charges.
FAQ : Questions fréquentes
Q1 : Quels sont les principaux défis mentionnés par OpenAI pour le stockage de ChatGPT ?
OpenAI a fait face à des défis majeurs pour adapter son infrastructure de stockage afin de gérer plus d’un milliard d’utilisateurs. Les principaux enjeux incluent la nécessité d’une architecture hautement évolutive, la gestion de pétaoctets de données, le maintien d’une faible latence pour les interactions en temps réel et l’optimisation des coûts associés à cette échelle massive.
Q2 : Comment ces défis impactent-ils les entreprises françaises qui déploient l’IA ?
Les entreprises françaises doivent anticiper ces mêmes défis lorsqu’elles déploient leurs propres solutions d’IA. Cela implique de planifier une infrastructure de stockage robuste et évolutive, de considérer les exigences de performance et de latence, et d’intégrer la sécurité des données dès la conception pour éviter les problèmes de scalabilité, de coûts et de conformité.
Q3 : Quelle est l’importance de la latence pour les applications d’IA comme ChatGPT ?
La latence est critique pour les applications interactives comme ChatGPT. Chaque milliseconde compte pour offrir une expérience utilisateur fluide et réactive. Une faible latence garantit que les réponses sont rapides, ce qui est essentiel pour l’engagement et la satisfaction de l’utilisateur, et nécessite des solutions de stockage optimisées pour la performance.
Q4 : Comment les entreprises peuvent-elles optimiser les coûts de leur infrastructure de stockage IA ?
L’optimisation des coûts passe par le choix de technologies de stockage adaptées au volume et à la fréquence d’accès aux données, l’utilisation de niveaux de stockage différenciés (chaud/froid), la mise en place de politiques de rétention efficaces, et l’adoption de pratiques FinOps pour une gestion rigoureuse des dépenses cloud. L’analyse des coûts doit être basée sur des scénarios d’utilisation réalistes.
Q5 : Pourquoi la sécurité et la confidentialité des données sont-elles si importantes dans ce contexte ?
Avec des réglementations strictes comme le RGPD, la sécurité et la confidentialité des données sont primordiales. Les entreprises doivent garantir la protection des données utilisateurs et sensibles via le chiffrement, une gestion rigoureuse des accès et des mécanismes de réponse aux incidents, même lors d’une croissance rapide, afin de maintenir la confiance et d’éviter les sanctions.
A lire aussi
Continuer avec des sujets proches
Besoin d’appliquer ce sujet ?
Transformer l’analyse en workflow utile.
FC Solutions peut aider à cadrer le cas d’usage, choisir les outils, automatiser le test local et vérifier le coût réel avant production.
Services associés