En bref
OpenAI a partagé des informations sur les mesures de sécurité mises en place pour protéger ses environnements d’entraînement de modèles d’IA avancés. Ces précautions visent à garantir l’intégrité des données et la confidentialité des recherches. Les entreprises françaises, confrontées à des enjeux similaires pour leurs propres projets d’IA, doivent porter une attention particulière à ces pratiques.
- La protection des données d’entraînement est primordiale pour maintenir la confiance et la performance des modèles d’IA.
- OpenAI met en œuvre des contrôles d’accès stricts et une surveillance continue de ses infrastructures.
- La sécurisation des données sensibles est essentielle pour prévenir les fuites et les utilisations malveillantes.
- Les entreprises doivent évaluer leurs propres protocoles de sécurité face aux risques croissants liés à l’IA.
- Une approche proactive de la cybersécurité est indispensable pour accompagner le développement de l’intelligence artificielle.
Sécurisation de l’environnement d’entraînement des modèles d’IA
OpenAI, acteur majeur dans le développement de l’intelligence artificielle, a récemment communiqué sur les mesures de sécurité qu’elle déploie pour protéger ses environnements d’entraînement de modèles d’IA de pointe. Ces infrastructures sont au cœur de la création de modèles comme GPT-4 et ses successeurs, et leur sécurisation est donc une priorité absolue. L’entreprise souligne l’importance de cette démarche pour maintenir la confiance de ses partenaires et du public, ainsi que pour garantir l’intégrité et la performance des modèles développés.
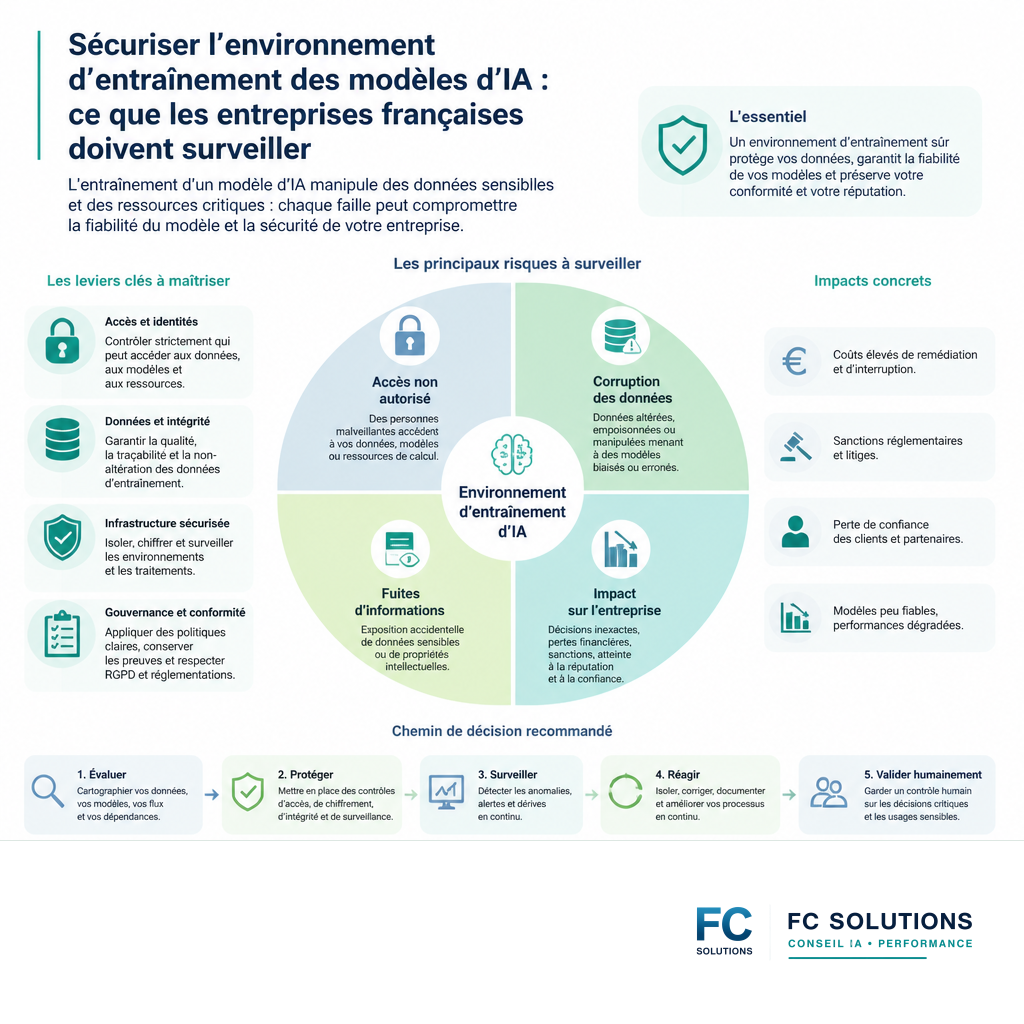
La formation de ces modèles nécessite l’accès à d’énormes volumes de données, souvent sensibles. La protection de ces données contre les accès non autorisés, les modifications ou les fuites est donc un enjeu critique. OpenAI a détaillé plusieurs aspects de sa stratégie de sécurité, incluant des contrôles d’accès rigoureux, une surveillance constante des systèmes et des protocoles de réponse aux incidents.
Contrôles d’accès et surveillance continue
Pour sécuriser son environnement d’entraînement, OpenAI a mis en place des contrôles d’accès stricts. Cela implique une authentification forte pour tout personnel accédant aux systèmes, ainsi qu’une gestion fine des permissions pour limiter l’accès aux seules données et ressources nécessaires à chaque tâche. L’entreprise a également renforcé la surveillance de ses infrastructures pour détecter toute activité suspecte en temps réel. Cette vigilance constante permet d’identifier et de réagir rapidement aux menaces potentielles, qu’elles soient internes ou externes.
La surveillance continue des systèmes est assurée par des outils avancés qui analysent les journaux d’activité et les flux de données. L’objectif est de détecter les anomalies qui pourraient indiquer une tentative d’intrusion ou une mauvaise utilisation des ressources. En cas de détection, des alertes sont déclenchées pour permettre une investigation immédiate et une action corrective.
Protection des données sensibles et confidentialité
La confidentialité des données utilisées pour l’entraînement des modèles est une préoccupation majeure. OpenAI s’engage à protéger ces informations conformément aux réglementations en vigueur et aux meilleures pratiques de l’industrie. Cela inclut le chiffrement des données au repos et en transit, ainsi que des procédures strictes pour la manipulation et le stockage des données sensibles. L’entreprise met l’accent sur la nécessité de prévenir les fuites de données, qui pourraient non seulement compromettre la confidentialité mais aussi affecter la performance et la fiabilité des modèles.
La gestion de la confidentialité s’étend également à la protection contre les risques liés à l’ingérence ou à la manipulation des données d’entraînement, qui pourraient introduire des biais indésirables ou des vulnérabilités dans les modèles finaux. Des audits réguliers et des évaluations de sécurité sont menés pour s’assurer de l’efficacité des mesures mises en place.
Implications pour les entreprises françaises
Les pratiques d’OpenAI en matière de sécurité des environnements d’entraînement d’IA offrent des enseignements précieux pour les entreprises françaises. Dans un contexte où l’intelligence artificielle devient de plus en plus intégrée aux processus métiers, la sécurisation des infrastructures et des données associées est un impératif stratégique. Les entreprises doivent évaluer leurs propres dispositifs de sécurité à la lumière des risques potentiels, qui incluent non seulement les cyberattaques, mais aussi les risques liés à la conformité réglementaire (comme le Règlement général sur la protection des données – RGPD) et à la réputation.
Il est crucial pour les entreprises françaises d’adopter une approche proactive de la cybersécurité. Cela passe par l’investissement dans des technologies de sécurité adaptées, la formation continue des équipes aux bonnes pratiques, et la mise en place de politiques de sécurité claires et appliquées. L’adoption de cadres de référence reconnus, tels que le NIST AI Risk Management Framework, peut aider à structurer cette démarche.
Cadre de référence et bonnes pratiques
Le NIST AI Risk Management Framework, par exemple, propose une approche structurée pour identifier, évaluer et gérer les risques liés à l’IA. Il encourage une approche holistique qui prend en compte les aspects techniques, organisationnels et éthiques. Les entreprises peuvent s’appuyer sur ce type de cadre pour développer leurs propres stratégies de sécurisation, en adaptant les recommandations à leur contexte spécifique.
De plus, le FinOps Foundation’s FinOps Framework peut être utile pour piloter les coûts associés à l’infrastructure IA, tout en maintenant un niveau de sécurité adéquat. Une gestion efficace des coûts cloud et IA est essentielle pour assurer la pérennité des projets d’intelligence artificielle.
Exemple concret : sécurisation d’un projet d’IA en PME
Une PME française développant une solution d’IA pour l’analyse prédictive de la maintenance industrielle pourrait mettre en œuvre les mesures suivantes pour sécuriser son environnement d’entraînement :
| Aspect de sécurité | Mesure mise en œuvre | Risque principal à mitiger | Validation humaine |
|---|---|---|---|
| Accès aux données d’entraînement | Authentification multi-facteurs (MFA) pour tous les accès aux serveurs de données et aux plateformes de développement. Gestion des rôles basée sur le principe du moindre privilège. | Accès non autorisé aux données sensibles, fuite d’informations propriétaires. | Vérification périodique des droits d’accès et des logs d’activité par le responsable IT. |
| Intégrité des données | Mise en place de sommes de contrôle (checksums) pour vérifier l’intégrité des jeux de données avant et après chaque étape de traitement. Utilisation de systèmes de stockage résilients. | Altération des données d’entraînement, introduisant des biais ou des erreurs dans le modèle. | Audit des processus de validation des données par un data scientist avant l’entraînement du modèle. |
| Sécurité du code et des scripts | Revue de code systématique pour tous les scripts d’entraînement et de prétraitement. Utilisation d’outils d’analyse statique de sécurité. | Introduction de vulnérabilités ou de portes dérobées dans le code d’entraînement. | Validation par un pair développeur ou un expert en sécurité avant intégration. |
| Protection contre les attaques par empoisonnement (data poisoning) | Filtrage et validation rigoureuse des sources de données externes. Surveillance des distributions statistiques des données d’entraînement pour détecter des anomalies. | Introduction de données malveillantes visant à corrompre le modèle. | Analyse par un expert en IA des anomalies détectées et validation des seuils de détection. |
Points de vigilance pour les entreprises françaises
Les entreprises françaises qui développent ou utilisent des modèles d’IA doivent considérer la sécurisation de leurs environnements d’entraînement comme une composante essentielle de leur stratégie. Les leçons tirées des pratiques d’OpenAI soulignent plusieurs points de vigilance :
- Conformité réglementaire : Assurer la conformité avec le RGPD et toute autre réglementation applicable à la protection des données est fondamental. Les données d’entraînement, si elles contiennent des informations personnelles, doivent être traitées avec le plus grand soin.
- Gestion des risques : Une évaluation continue des risques liés à la sécurité des données et à l’intégrité des modèles est nécessaire. Cela inclut les risques de cyberattaques, mais aussi les risques d’erreurs humaines ou de mauvaise configuration.
- Formation et sensibilisation : Le personnel impliqué dans le développement et la gestion des environnements d’IA doit être formé aux meilleures pratiques de sécurité. La sensibilisation aux menaces potentielles est une première ligne de défense efficace.
- Partenariats et fournisseurs : Si des services tiers sont utilisés pour l’entraînement ou le stockage des données, il est crucial de vérifier leurs propres mesures de sécurité et de s’assurer qu’elles répondent aux exigences de l’entreprise.
FAQ : Questions fréquentes
Q1 : Pourquoi la sécurisation de l’environnement d’entraînement est-elle si importante pour les modèles d’IA ?
La sécurisation de l’environnement d’entraînement est cruciale car il manipule d’énormes volumes de données, souvent sensibles. Une faille peut entraîner des fuites de données, la corruption du modèle, l’introduction de biais, ou des utilisations malveillantes, compromettant la fiabilité et la sécurité de l’IA.
Q2 : Quelles sont les principales menaces pesant sur les environnements d’entraînement d’IA ?
Les principales menaces incluent les cyberattaques visant à voler ou altérer les données, l’accès non autorisé par des personnes malintentionnées, l’empoisonnement des données (data poisoning) pour corrompre le modèle, et les risques liés à la mauvaise gestion des accès et des permissions.
Q3 : Comment les entreprises françaises peuvent-elles s’inspirer des pratiques d’OpenAI ?
Elles peuvent adopter des contrôles d’accès stricts avec authentification forte, mettre en place une surveillance continue des infrastructures, chiffrer les données sensibles, et définir des protocoles clairs pour la manipulation et le stockage des données, tout en formant leurs équipes.
Q4 : Le RGPD s’applique-t-il aux données utilisées pour l’entraînement des modèles d’IA ?
Oui, si les données d’entraînement contiennent des informations personnelles identifiables, le RGPD s’applique pleinement. Les entreprises doivent garantir la conformité en matière de consentement, de minimisation des données et de sécurité lors de la collecte et de l’utilisation de ces données.
Q5 : Quels sont les risques si les données d’entraînement sont compromises ?
La compromission des données d’entraînement peut entraîner des fuites d’informations confidentielles, la perte de propriété intellectuelle, la création de modèles biaisés ou défectueux, une atteinte à la réputation de l’entreprise, et des sanctions réglementaires.
Q6 : Faut-il investir massivement dans la sécurité pour les PME ?
Les PME doivent investir proportionnellement à leur exposition au risque. L’adoption de bonnes pratiques, l’utilisation d’outils de sécurité adaptés et la formation du personnel sont des étapes clés, même avec un budget limité. L’approche doit être pragmatique et basée sur une évaluation des risques.
A lire aussi
Continuer avec des sujets proches
Besoin d’appliquer ce sujet ?
Transformer l’analyse en workflow utile.
FC Solutions peut aider à cadrer le cas d’usage, choisir les outils, automatiser le test local et vérifier le coût réel avant production.
Services associés